Международное общество «Қазақ тілі» представило результаты совместного проекта с компанией OpenAI
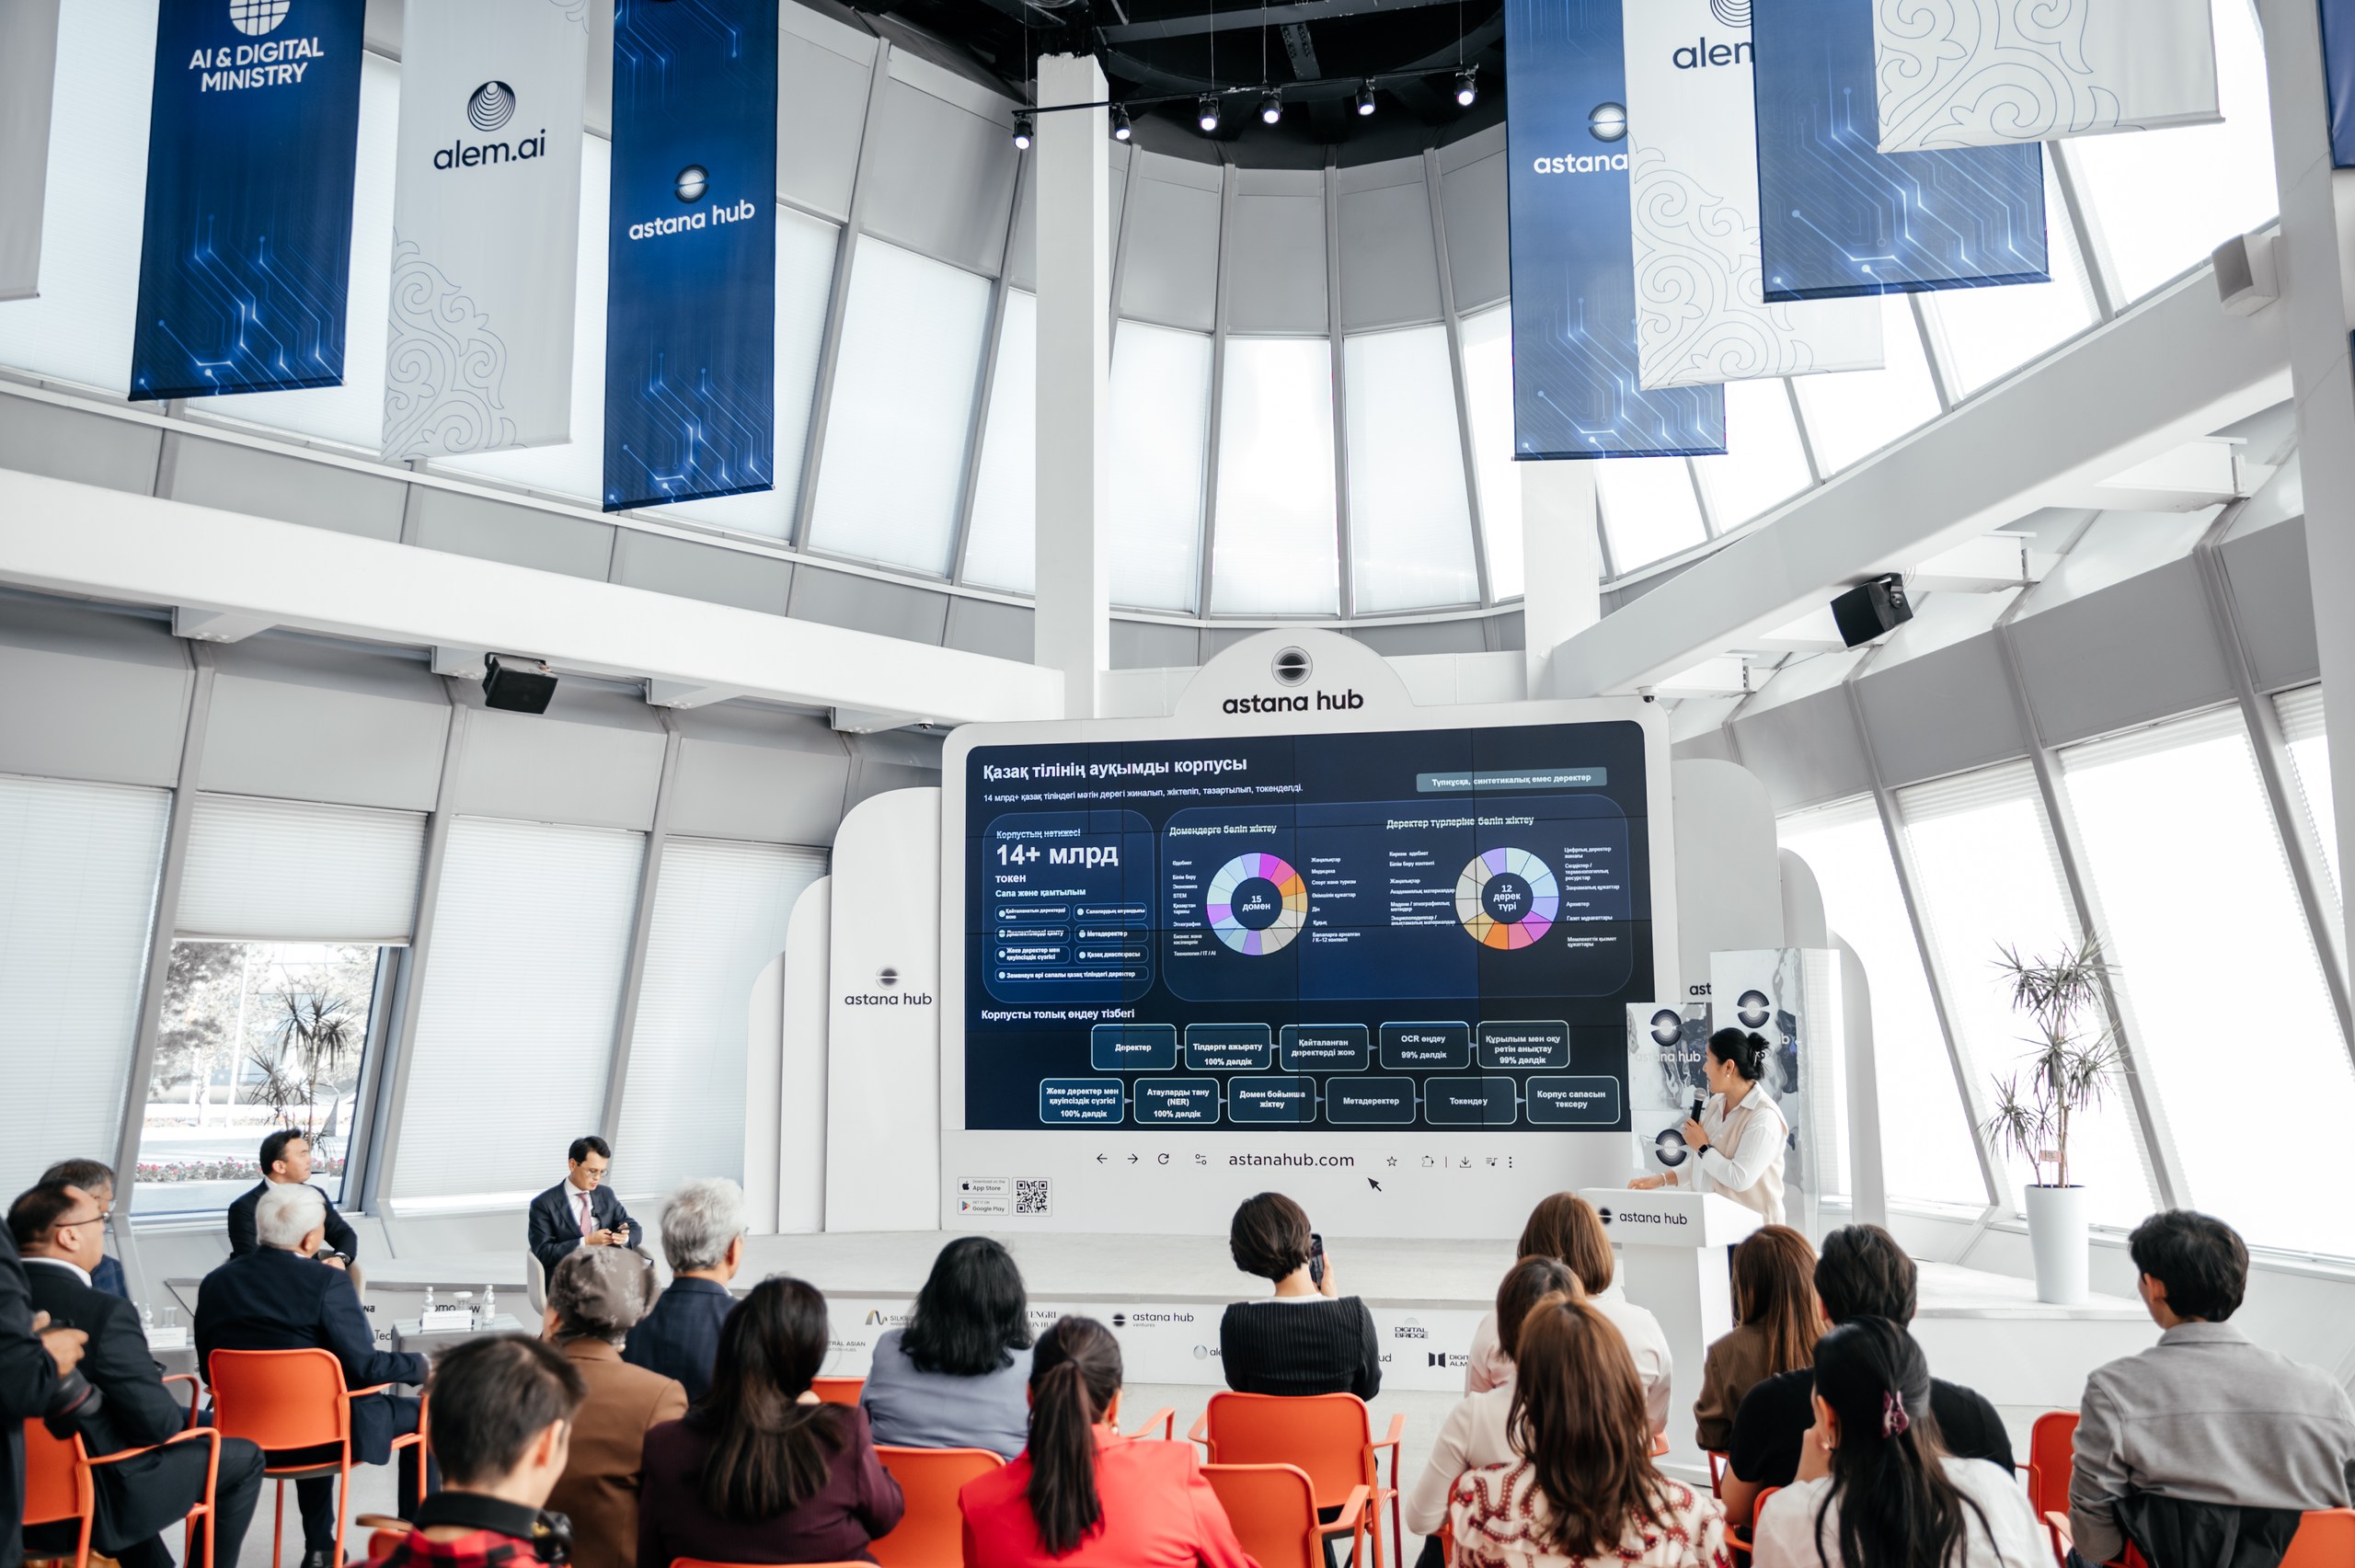
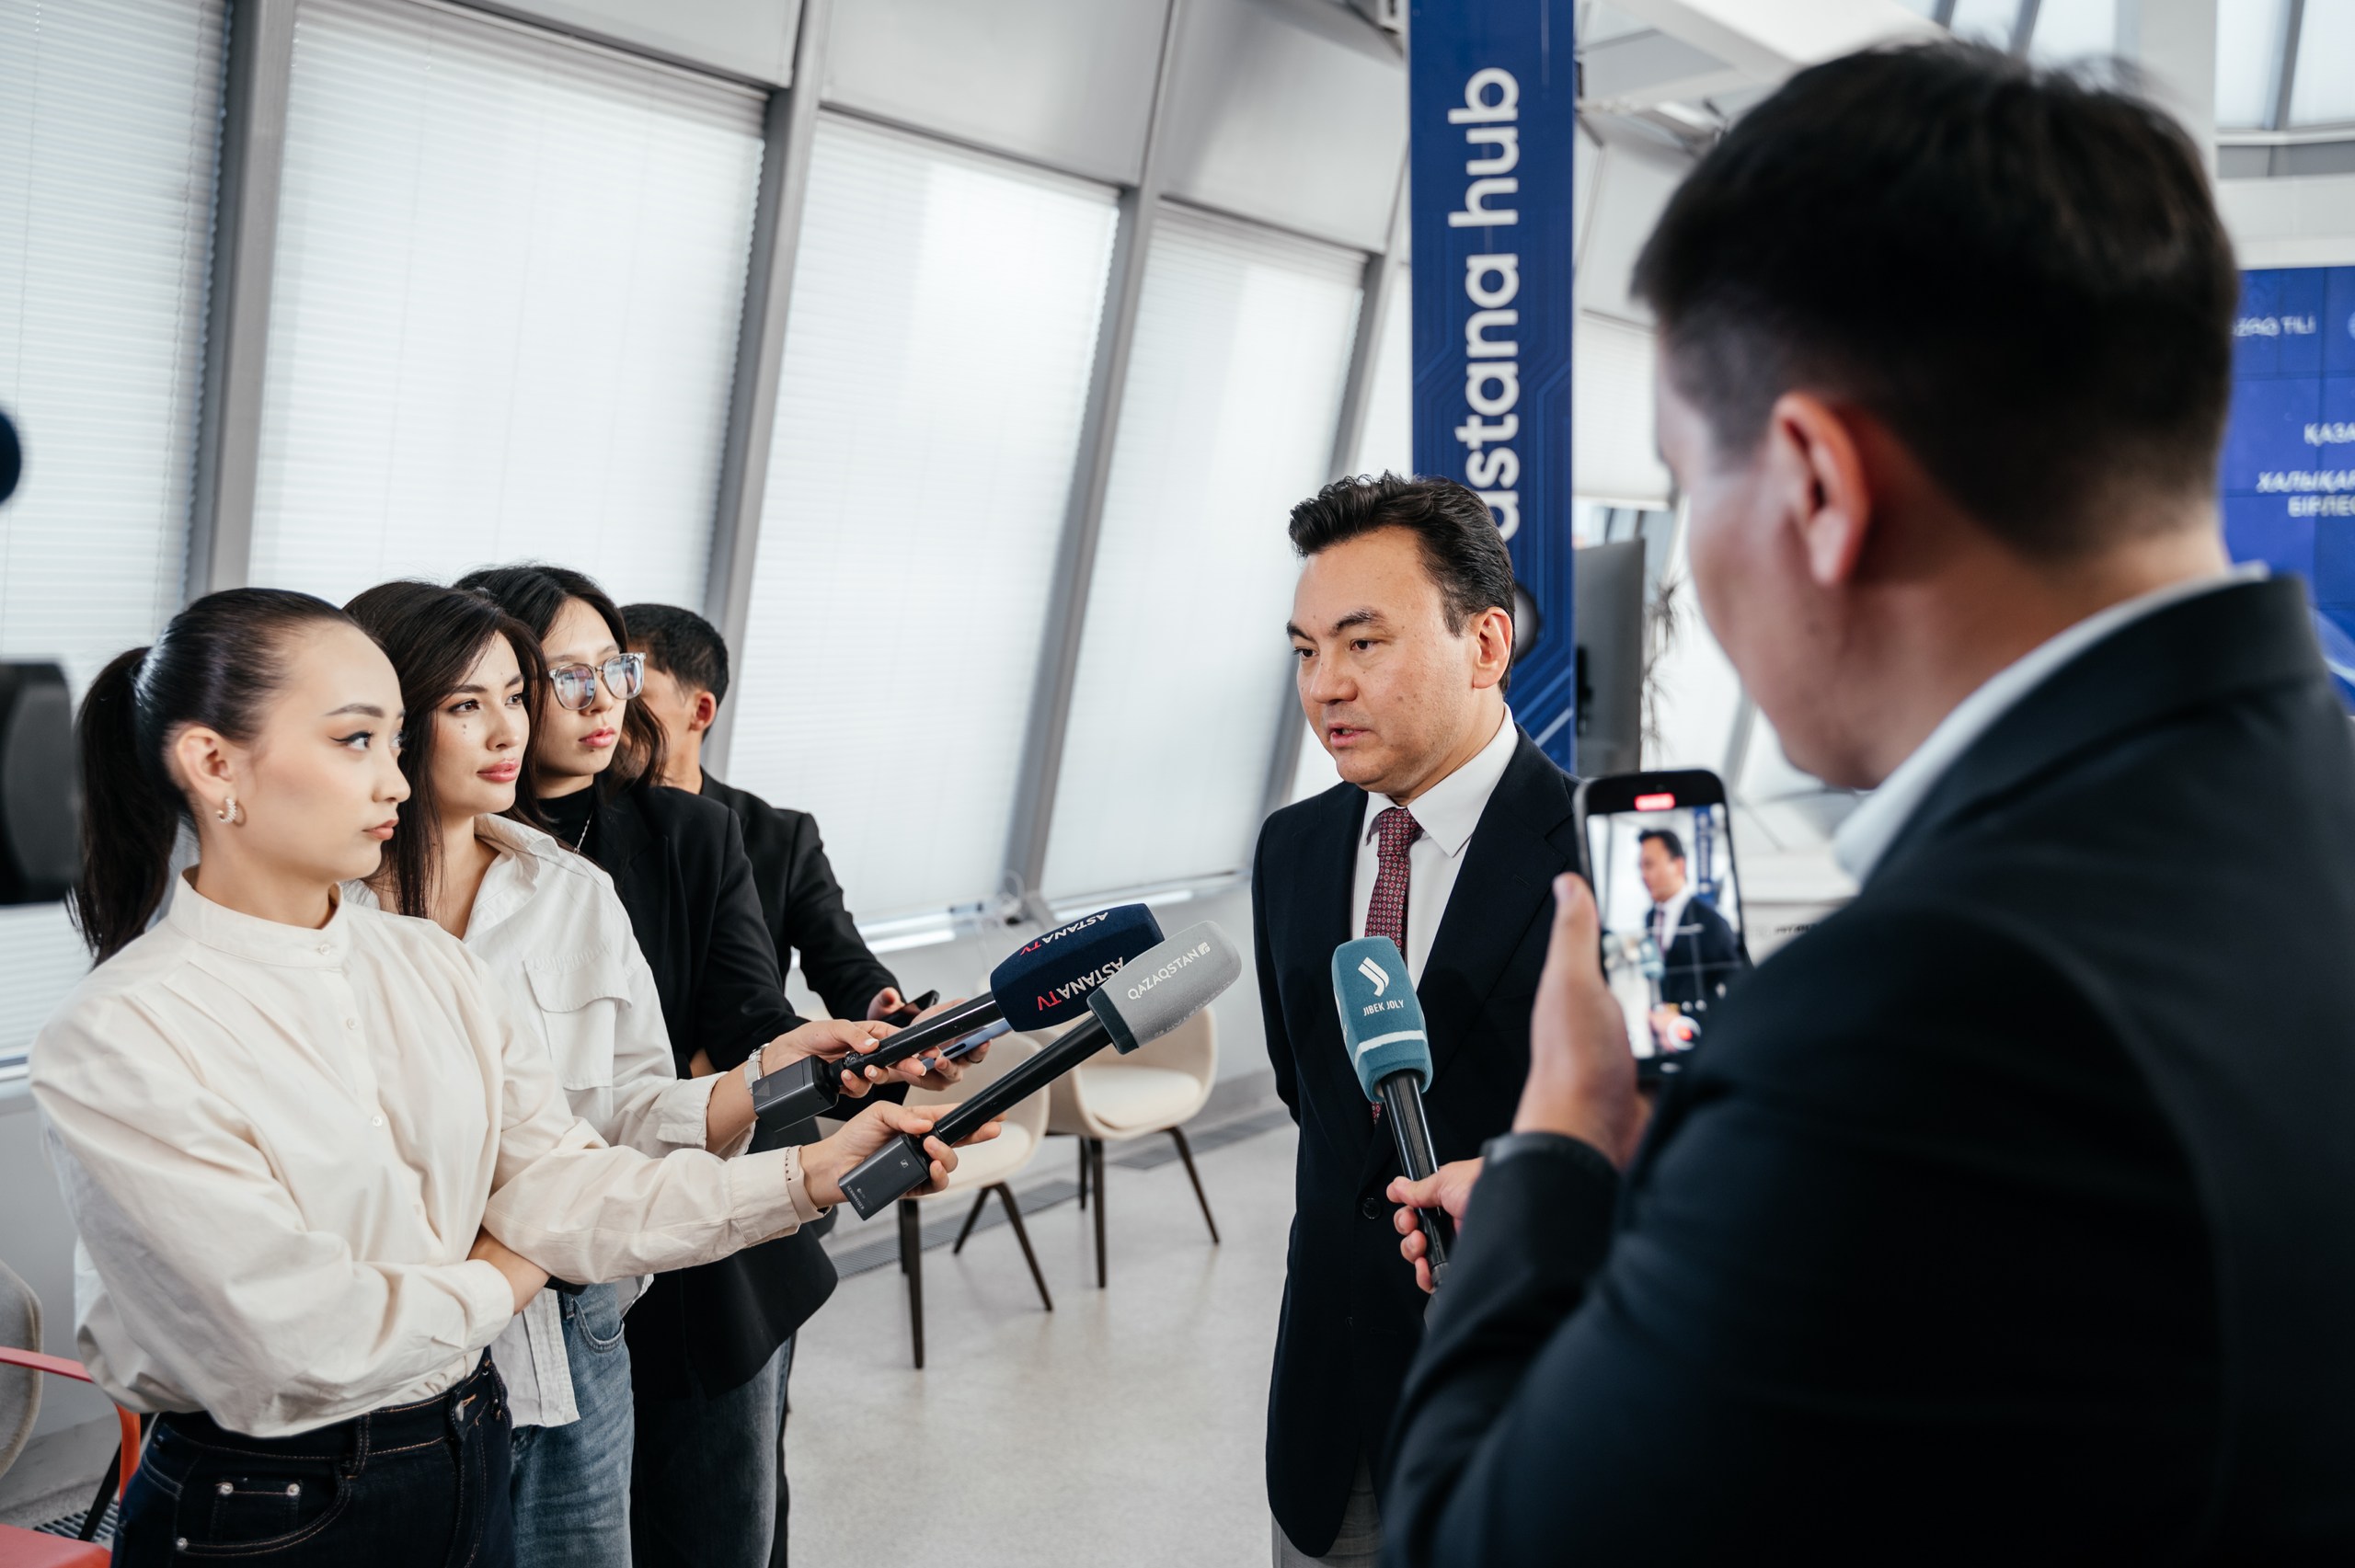
3 сентября в Астане были представлены результаты совместного проекта Международного общества «Қазақ тілі» и компании OpenAI, направленного на развитие казахского языка в цифровой среде. В рамках проекта объем текстового корпуса казахского языка достиг 14 миллиардов токенов, а объем аудиоданных – 12 тысяч часов. Точность адаптированных для казахского языка моделей транскрипции повысилась до 98%.
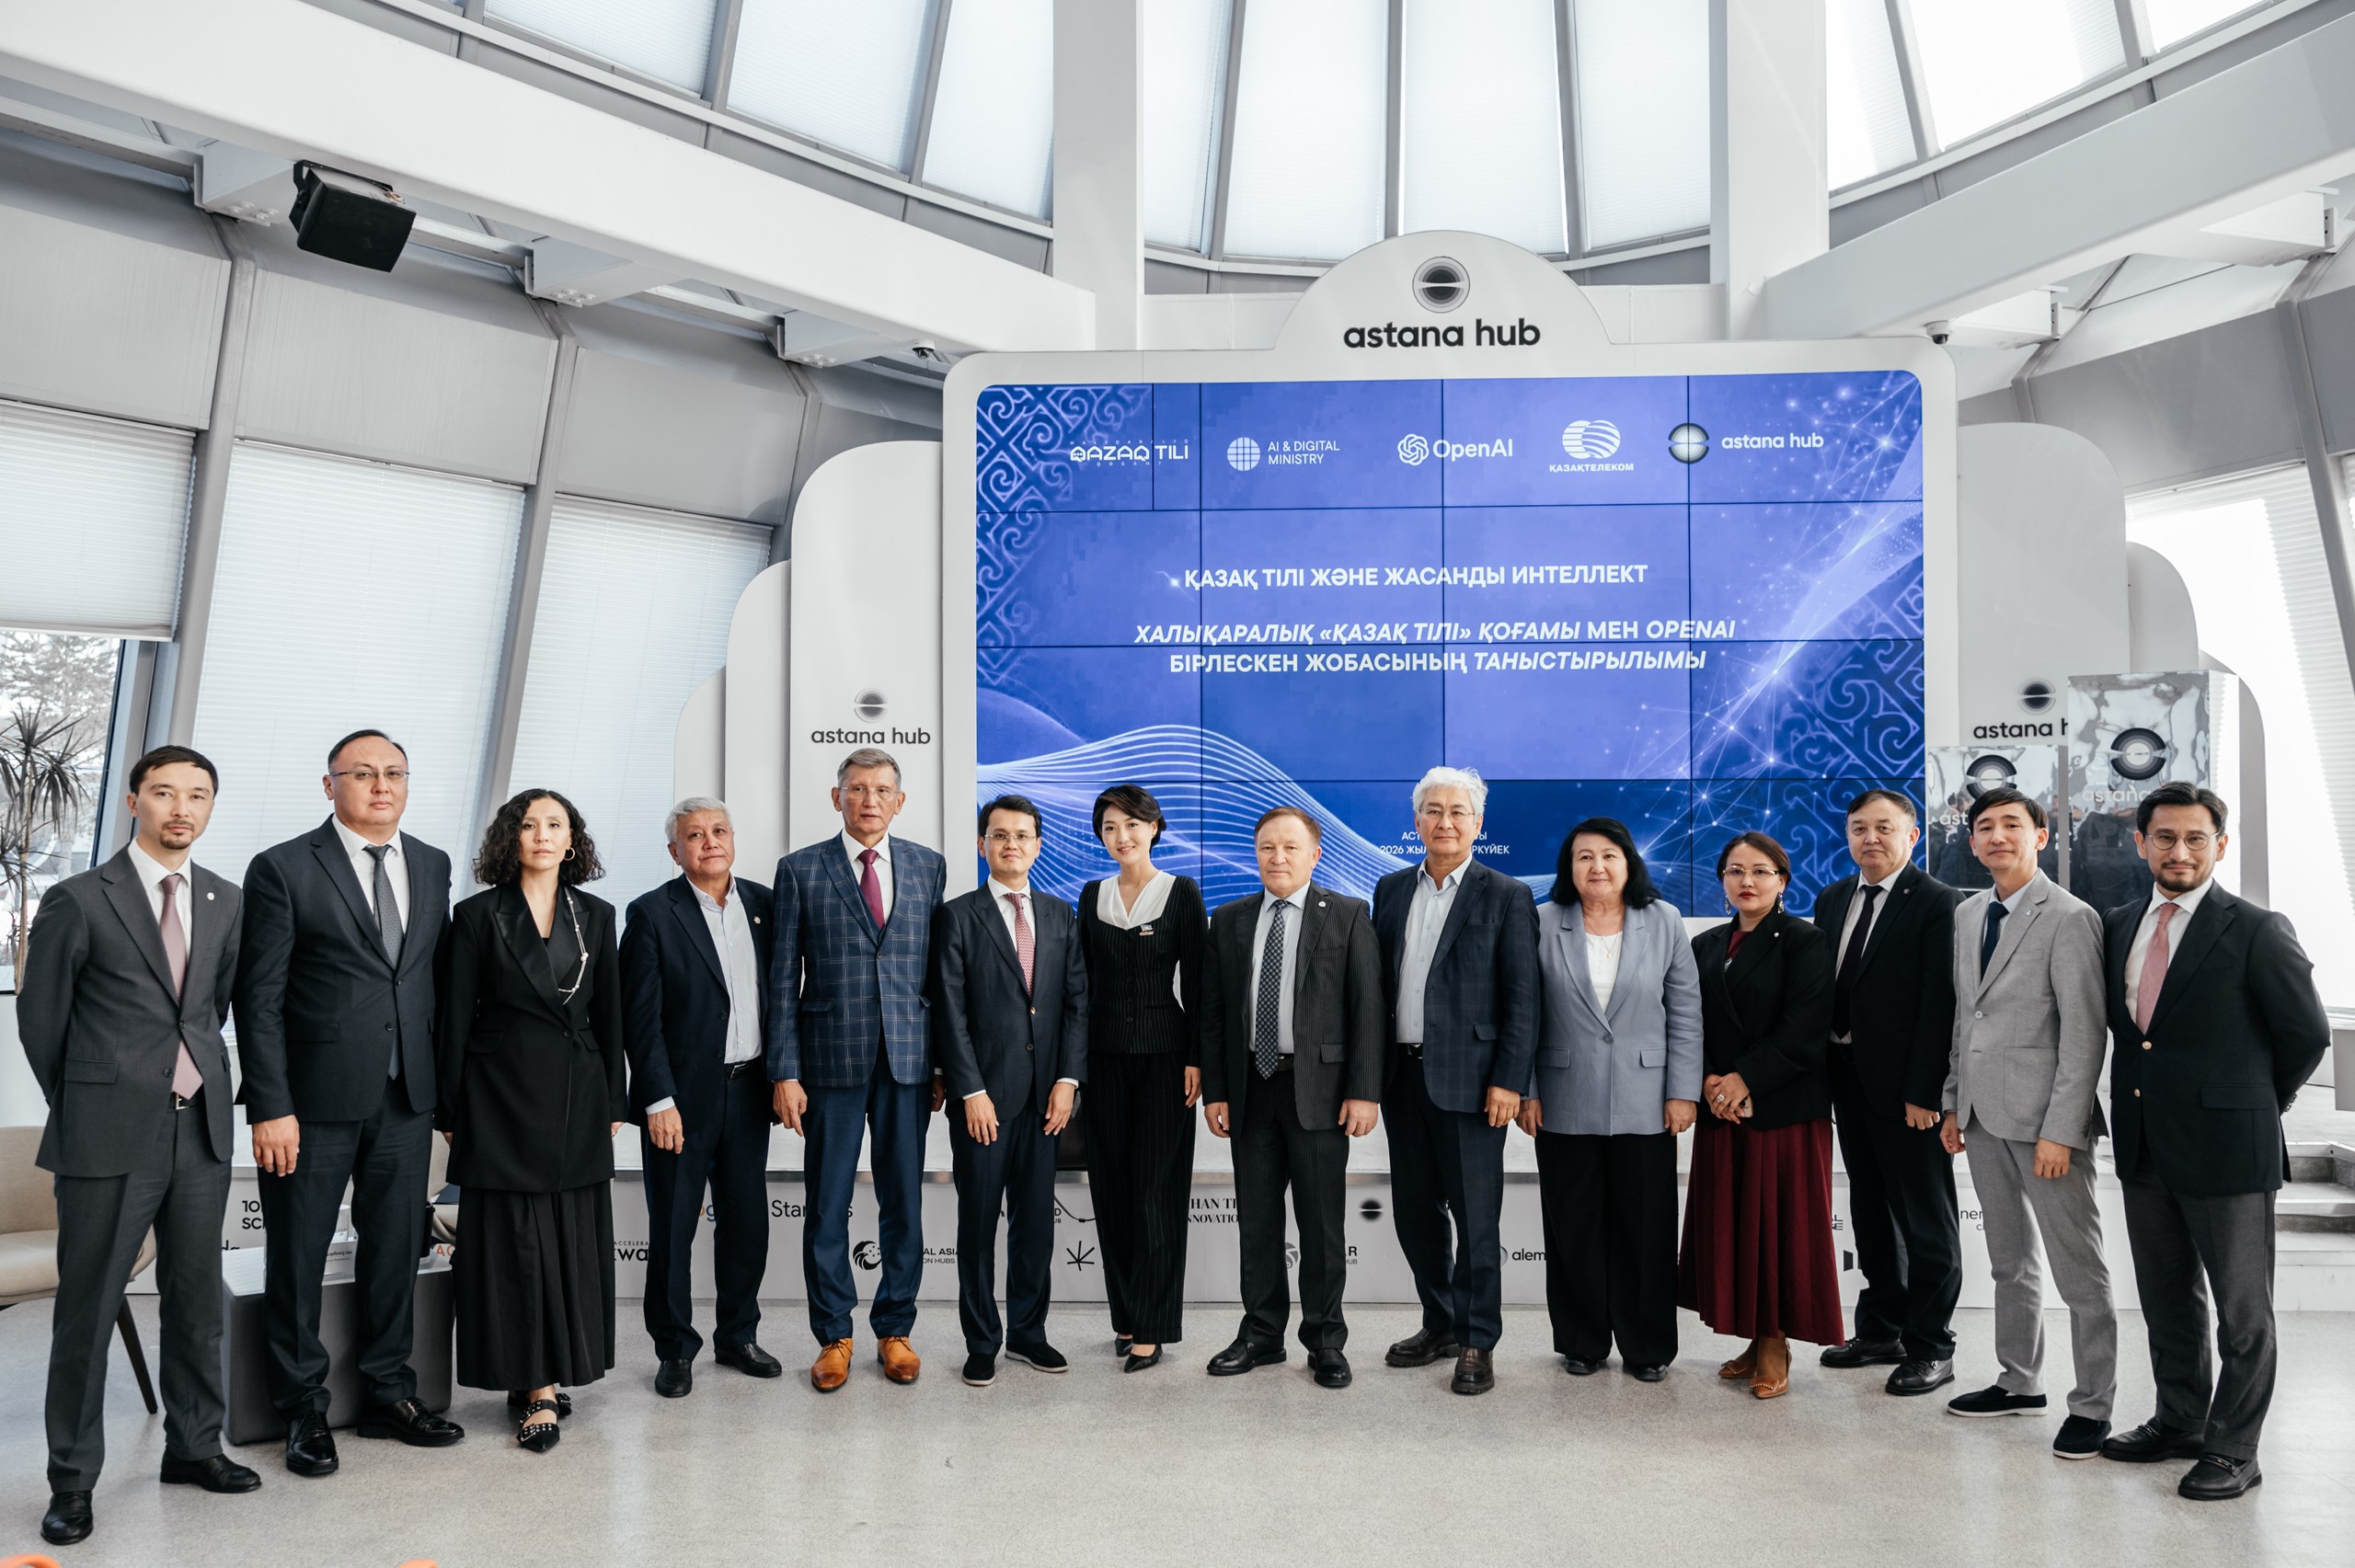
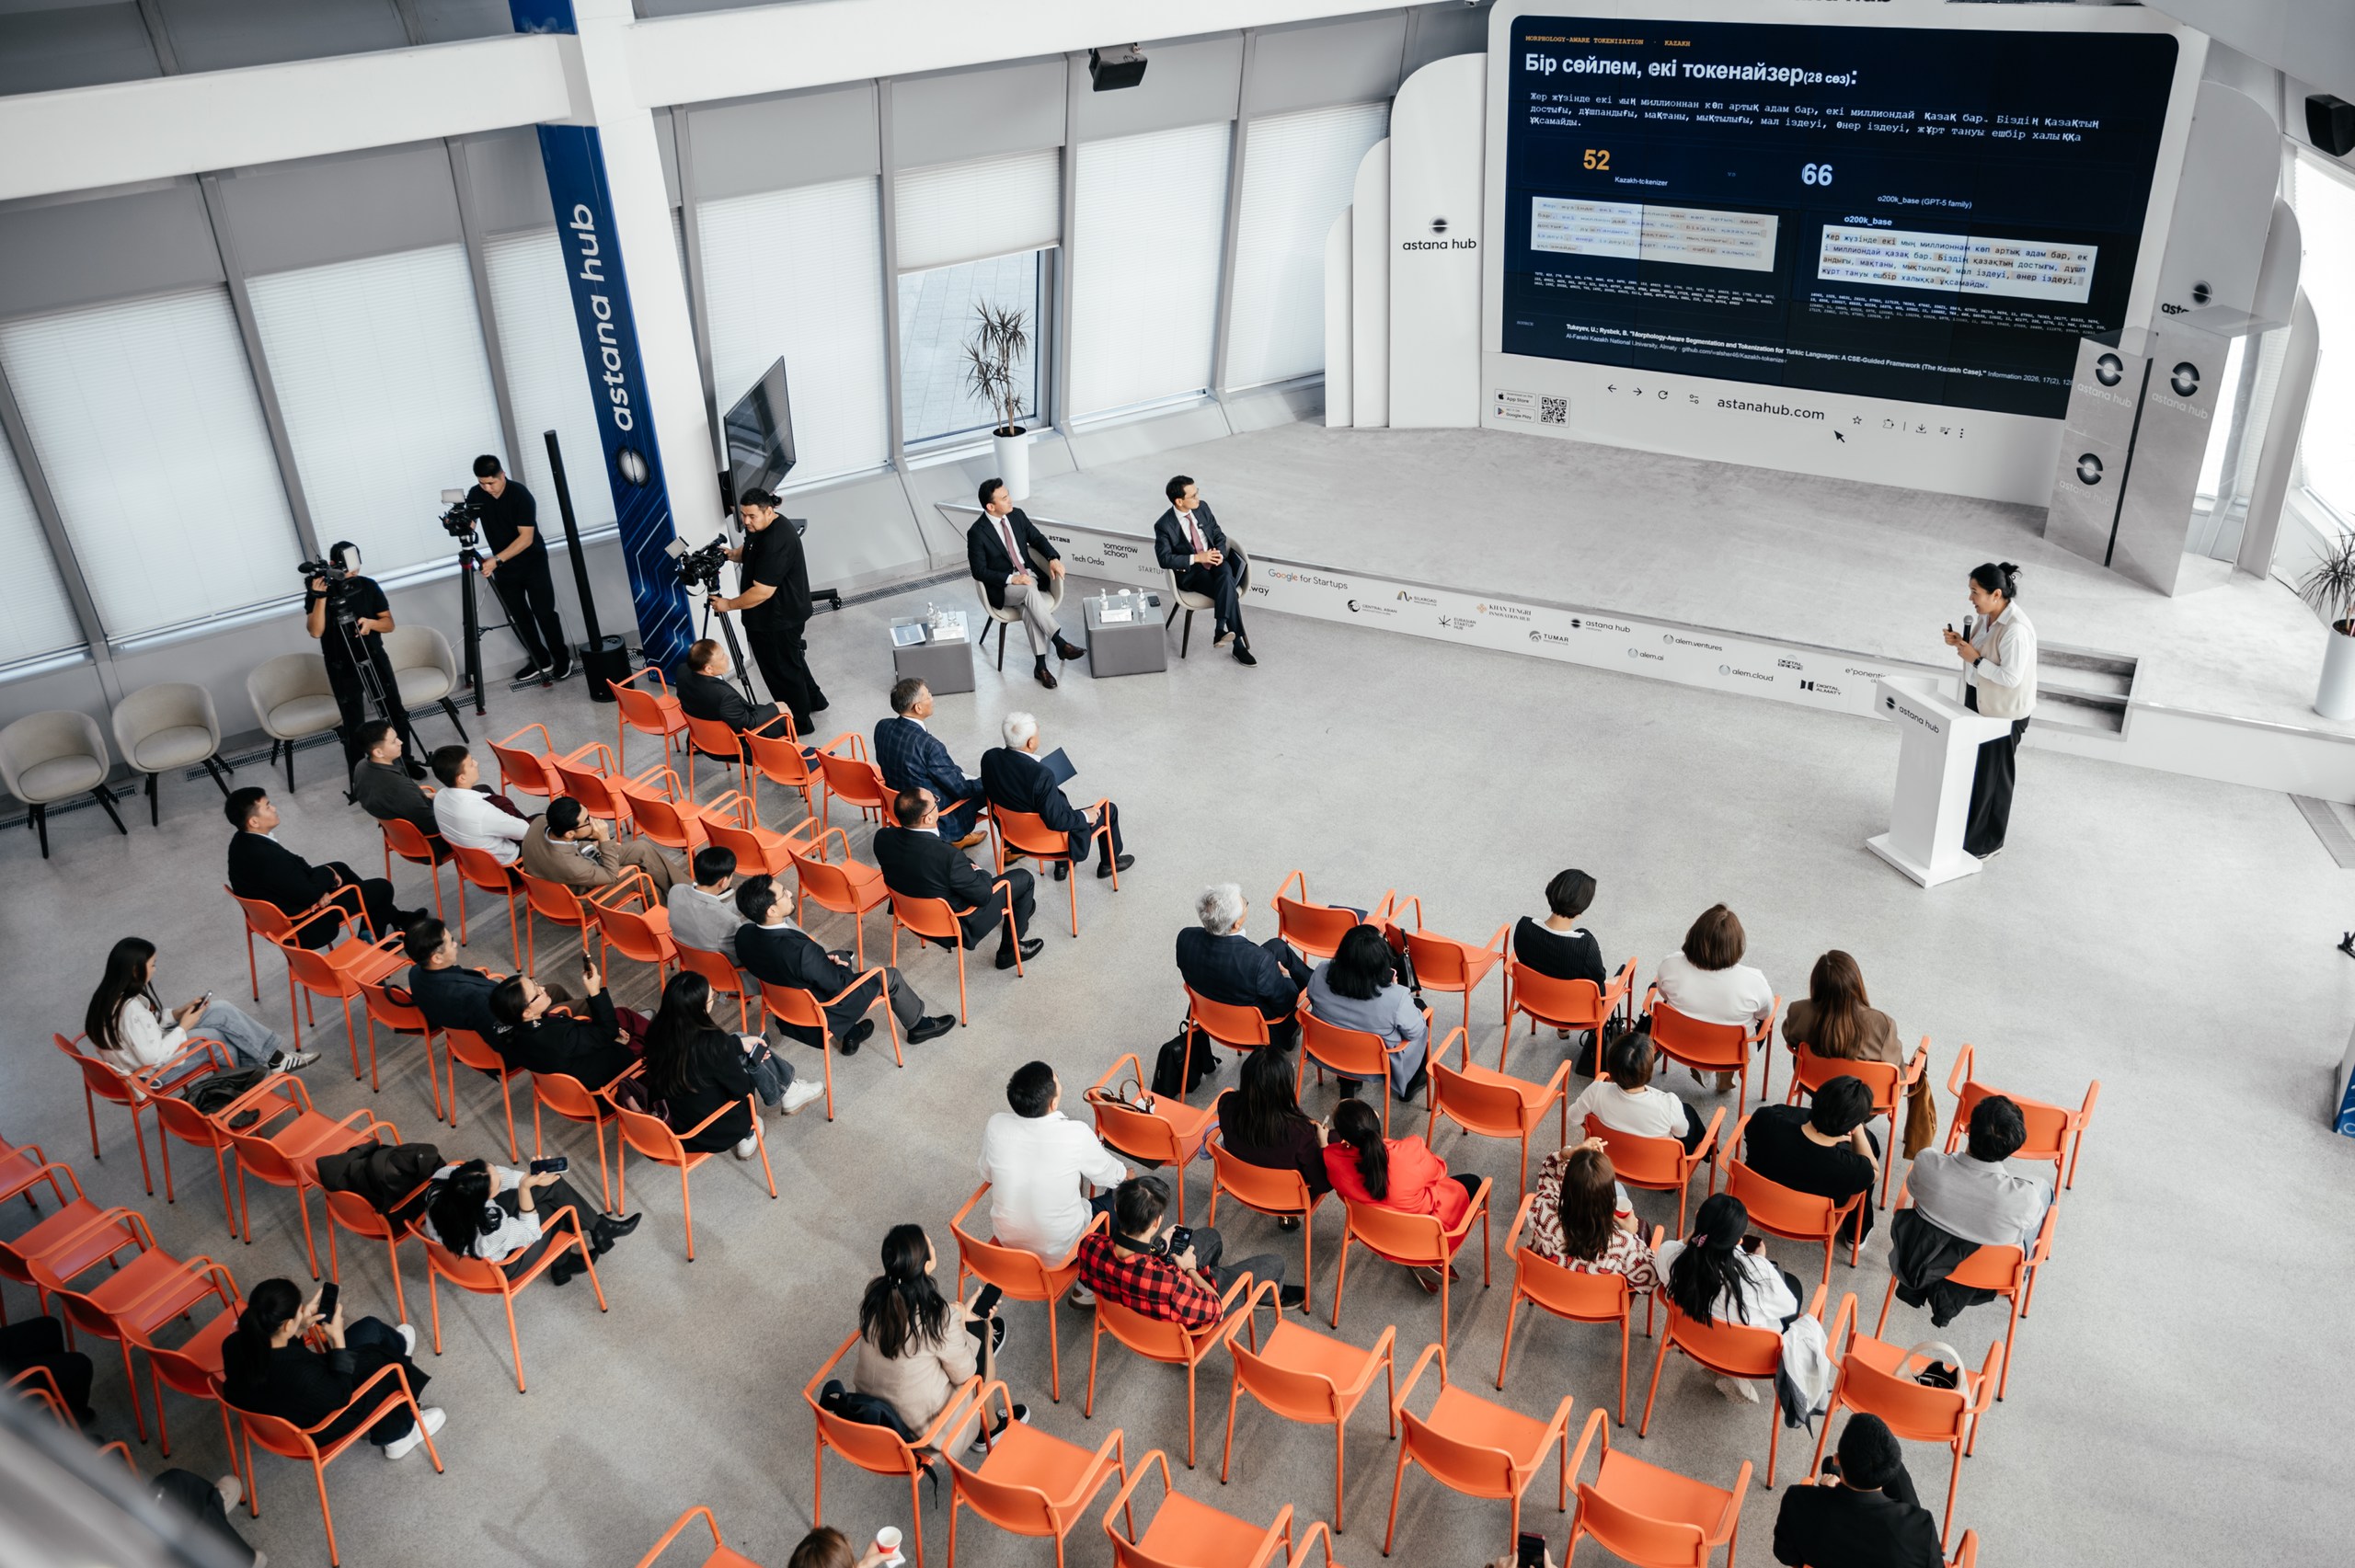
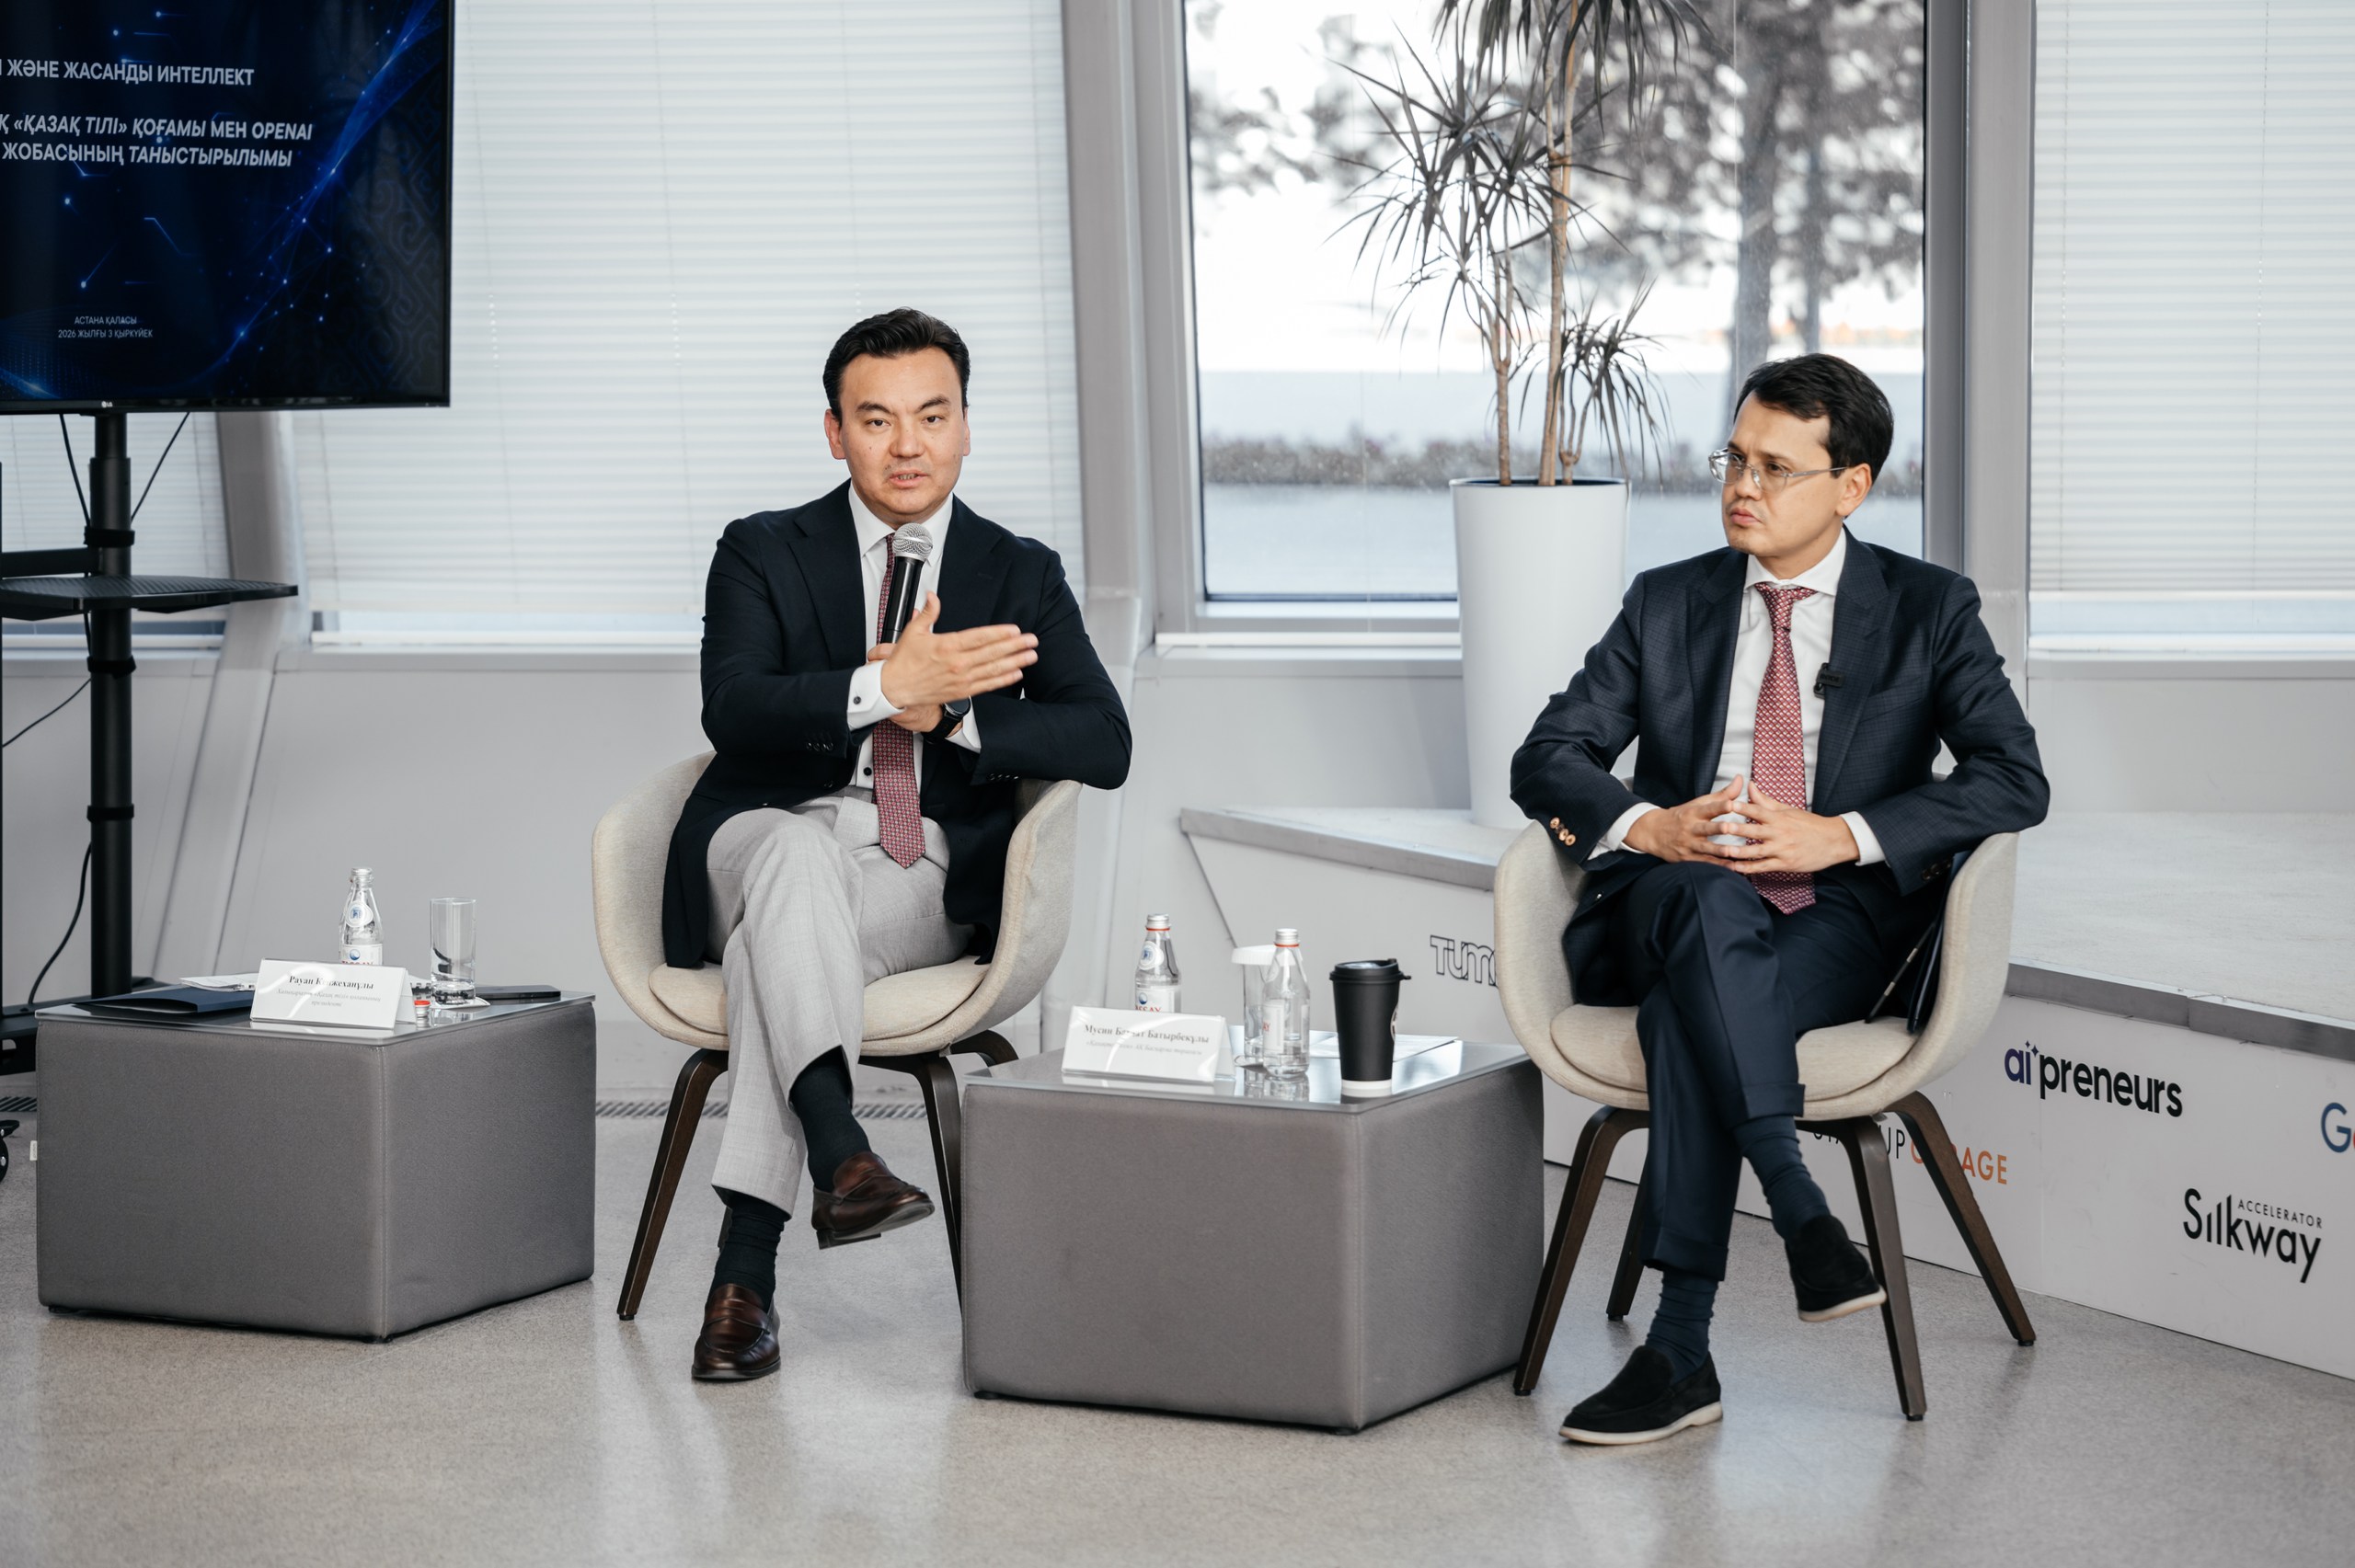
В мероприятии, прошедшем в Astana Hub, приняли участие президент Международного общества «Қазақ тілі» Рауан Кенжеханулы, председатель Правления АО «Казахтелеком» Багдат Мусин, учредители Общества и члены Центрального совета, IT-эксперты и специалисты в области языка.
Масштабная инициатива Международного общества «Қазақ тілі» и OpenAI реализуется в рамках соглашения, заключенного 7 ноября 2025 года в Вашингтоне. Главная цель проекта – повысить качество работы больших языковых моделей (LLM) на казахском языке за счет формирования качественного цифрового контента и надежной базы данных.
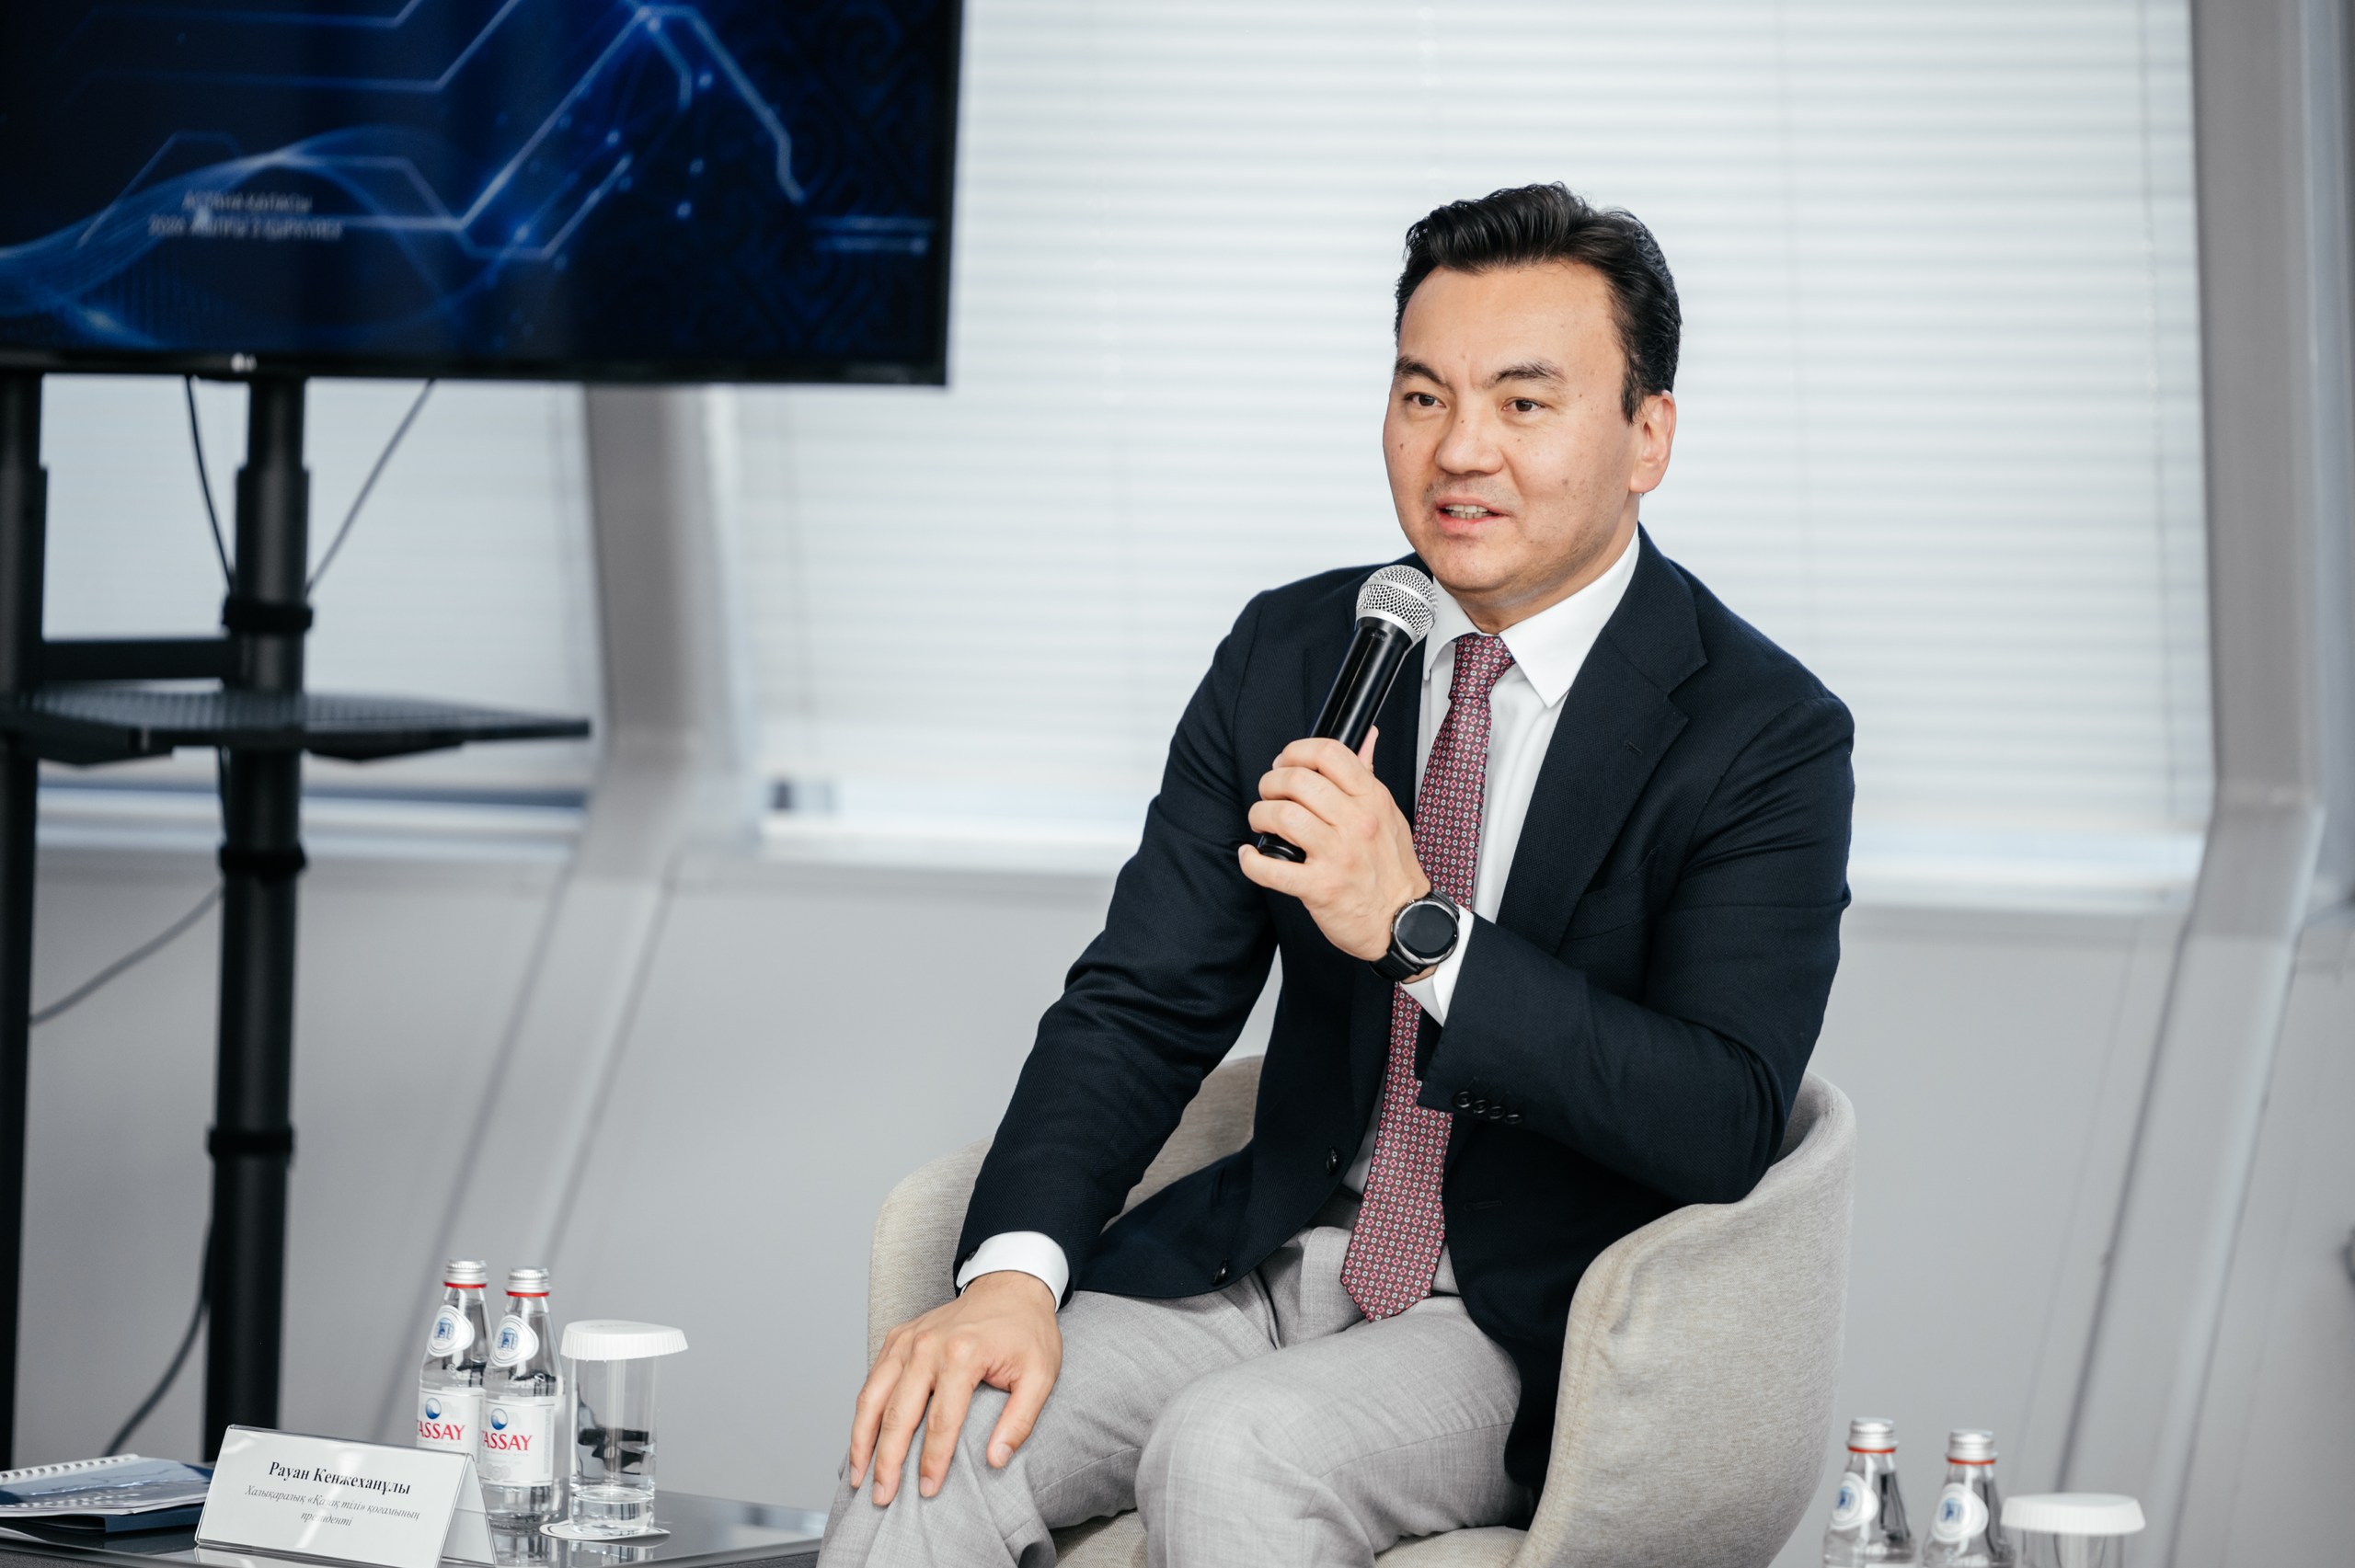
«Наша цель – создать условия для полноценного использования казахского языка в эпоху искусственного интеллекта. Для этого важно не только перенести богатейший языковой фонд в цифровую среду, но и добиться того, чтобы искусственный интеллект естественно понимал казахский язык, правильно его использовал и учитывал национальный культурный контекст. Поэтому мы не ограничиваемся формированием базы данных и уделяем особое внимание ее качеству, а также инструментам оценки языковых моделей. Это не разовый проект, а системная и долгосрочная работа», – отметил президент Международного общества «Қазақ тілі» Рауан Кенжеханулы.
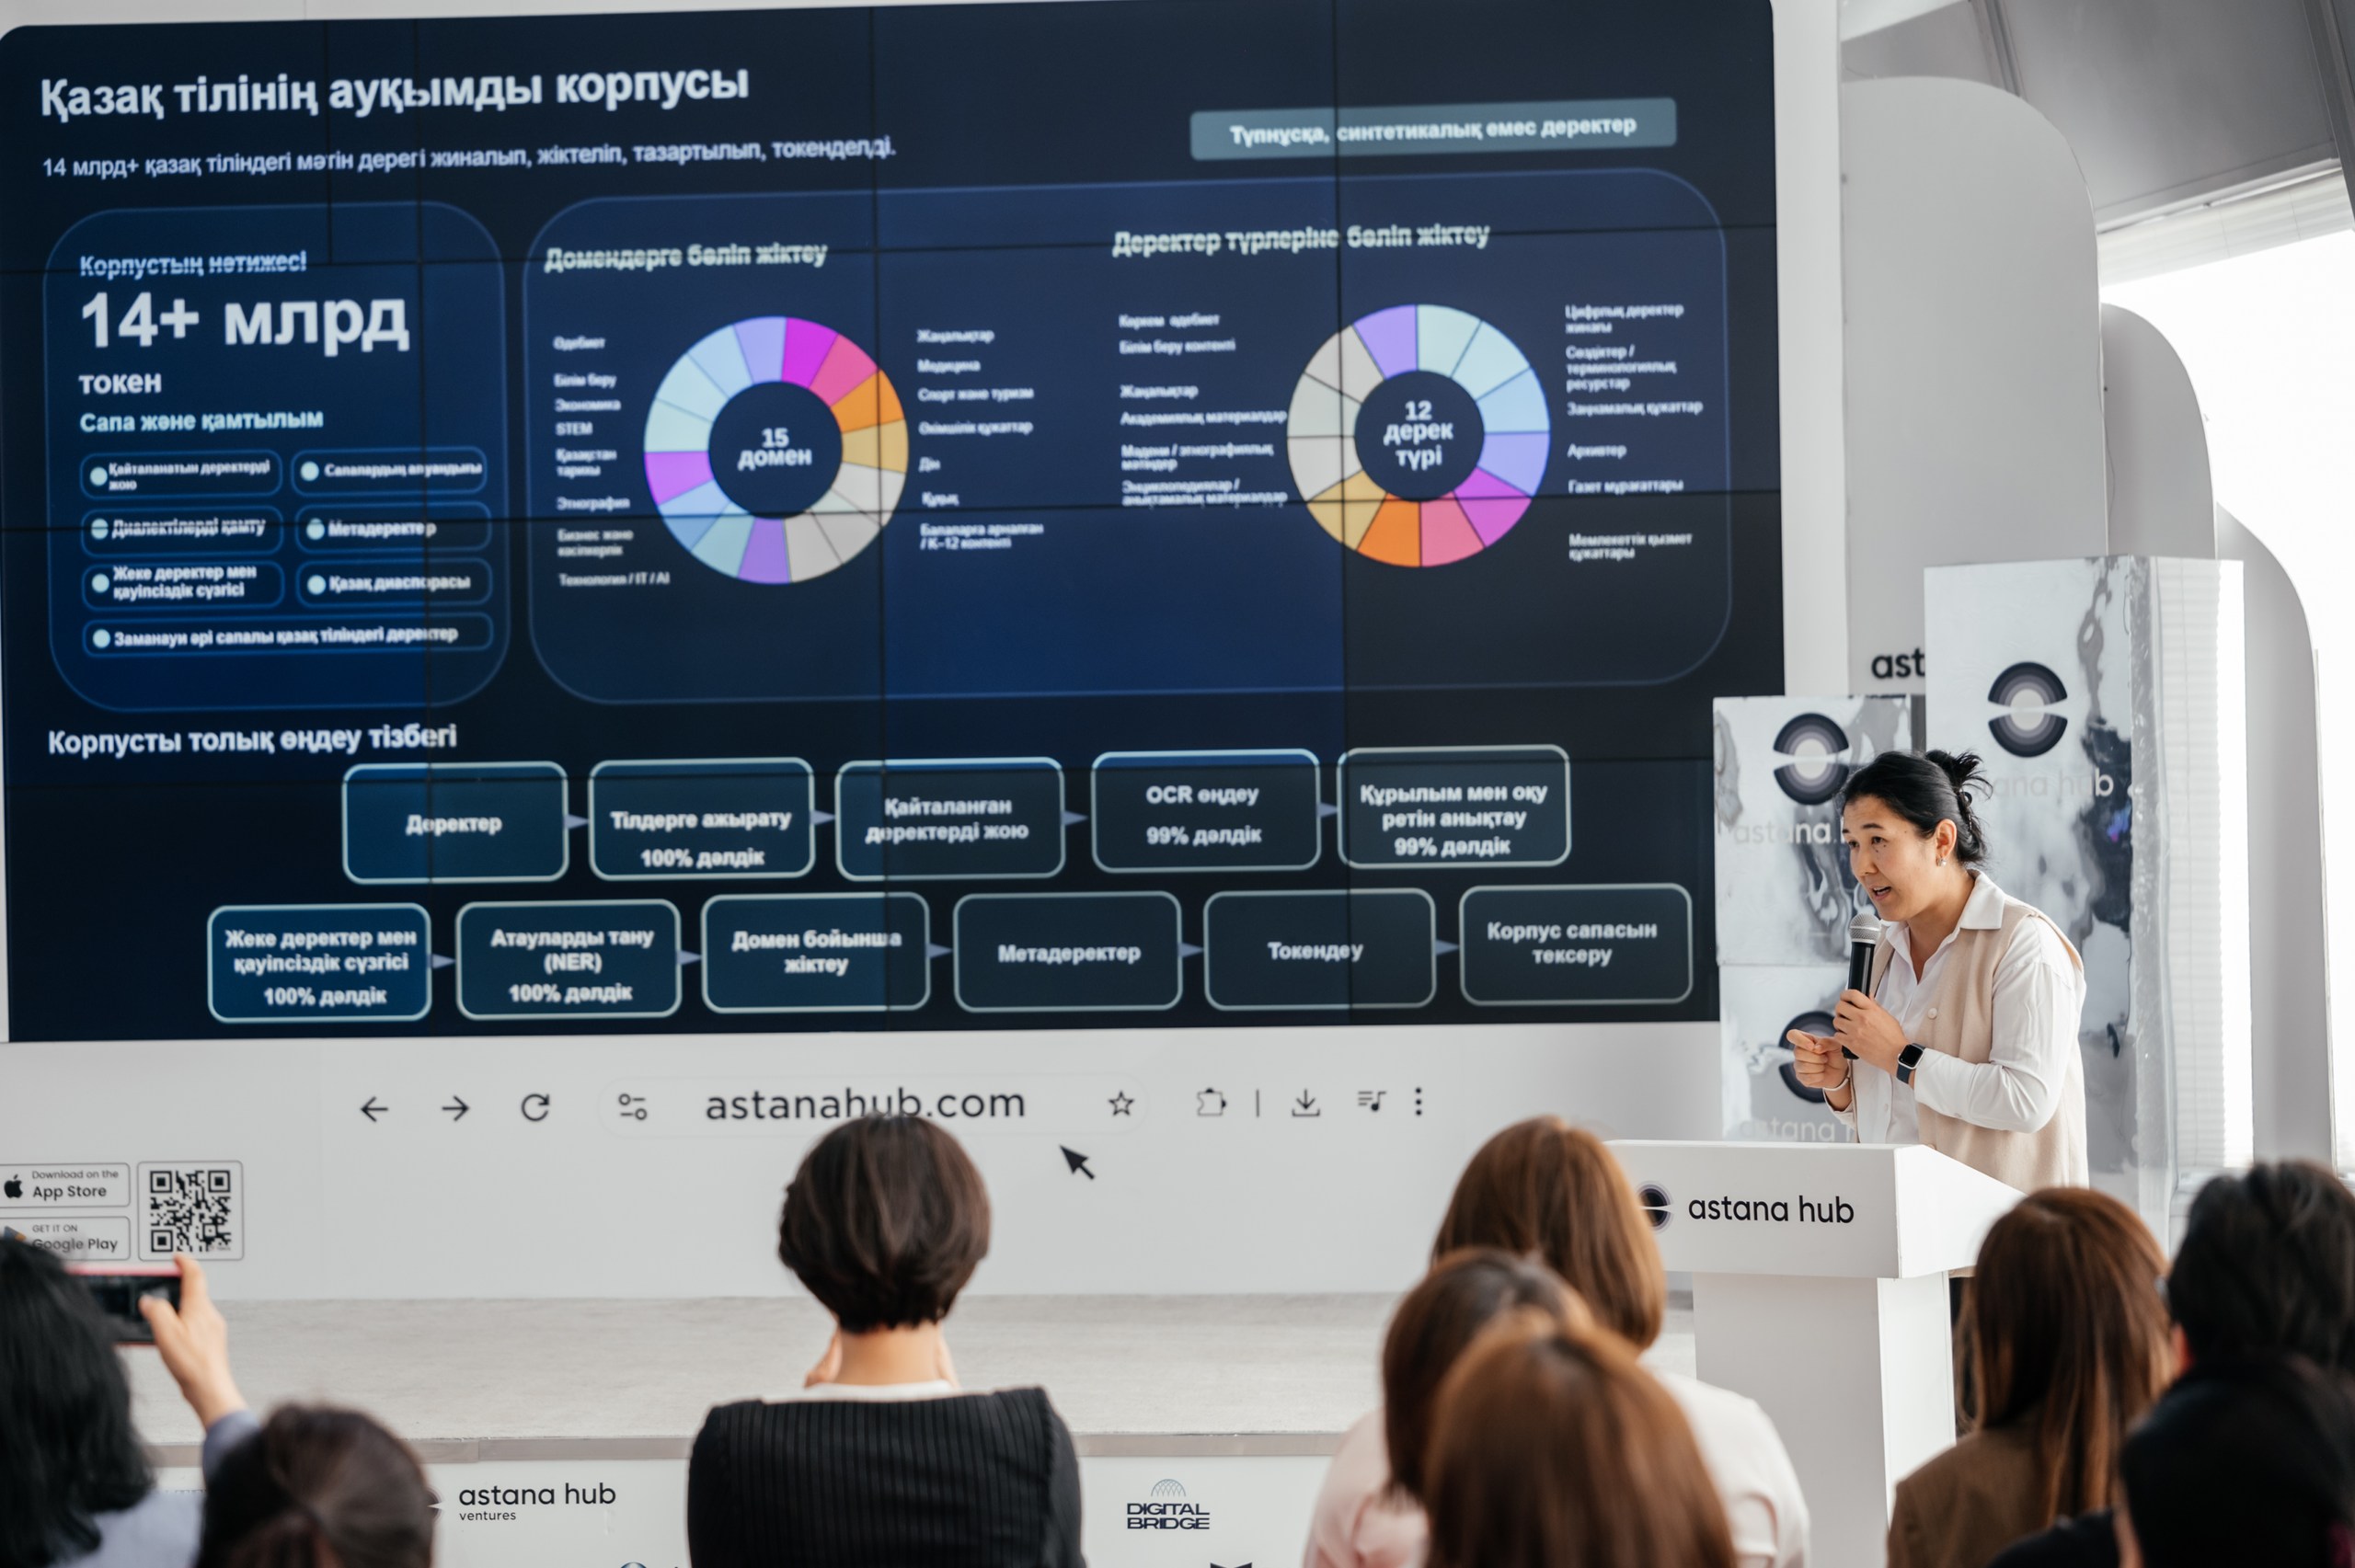
В рамках проекта формируется качественный корпус текстовых и речевых данных на казахском языке, на основе которого разрабатываются инструменты искусственного интеллекта. Объем текстового корпуса казахского языка (Kazakh Text Corpus) достиг 14 миллиардов токенов. Материалы в нем классифицированы по тематике, жанрам и возрастным категориям. В корпус вошли как материалы, охватывающие исторические этапы развития казахского языка, так и языковое наследие казахской диаспоры за рубежом. Корпус охватывает материалы в сфере образования, науки, технологий, экономики, права, медицины, истории, этнографии и медиа, а также детский контент.
Объем аудиоданных составляет 12 тысяч часов. Все записи очищены от фонового шума, музыки и других посторонних звуков. Кроме того, внедрены модели транскрипции, адаптированные для казахского языка, благодаря чему точность преобразования речи в текст доведена до 98%.
«Когда мы начинали системную работу над искусственным интеллектом, перед нами встал принципиальный вопрос: на каком языке должен „думать" наш ИИ? Готовые зарубежные модели неплохо работают с английским и русским, но качественно понимать казахский язык — особенно его деловой, юридический, технический пласт — они не умеют. А без этого любая цифровая трансформация рискует оставить казахский язык на периферии: языком быта, но не языком технологий и государственного управления. Поэтому мы для себя решили — казахский язык должен быть полноценной, естественной средой работы искусственного интеллекта», – отметил глава АО «Казахтелеком» Багдат Мусин.
Одним из приоритетных направлений проекта является защита персональных данных. Для этого была разработана специальная модель, которая автоматически выявляет и удаляет персональную информацию из текстовых и аудиоданных. С ее помощью персональная информация была полностью удалена из текстового корпуса объемом более 14 миллиардов токенов и 12 тысяч часов аудиоданных.
Кроме того, разрабатываются инструменты Document AI и NLP (обработки естественного языка) для казахского языка. В их числе – OCR-система для высокоточного распознавания текстов на казахском языке, инструменты для определения структуры газет, книг и PDF-документов, корректного распознавания последовательности текста на многостолбцовых страницах, а также механизмы токенизации, NER (распознавания именованных сущностей) и очистки данных. Эти технологии позволят оцифровывать архивные материалы и учебники, а также повысить качество поиска и обработки цифрового контента на казахском языке.
Ранее была разработана система оценки AI Evaluation Benchmark Suite, предназначенная для проверки уровня владения казахским языком системами искусственного интеллекта. Она тестирует большие языковые модели по таким направлениям, как понимание текста (Reading Comprehension), грамматика (Grammar), естественность казахской речи (Kazakh Language Naturalness), использование пословиц, поговорок и устойчивых выражений (Proverbs & Idioms), академический перевод (Academic Translation), художественный перевод с казахского на английский язык (Literary Translation), перевод детской литературы (Kids Literature Translation), безопасность (Safety) и знание этнографии (Ethnography). Система оценки не была переведена с английского языка, а изначально разработана на казахском с учетом языковых и культурных особенностей казахского языка.
В настоящее время направление AI Evaluation Benchmark Suite по оценке этнографических знаний (Ethnography) расширено: разработан полноценный бенчмарк, включающий 500 вопросов. Он позволяет оценить знания больших языковых моделей об истории, традициях и культуре казахского народа. Модель GPT-5.6 Terra, прошедшая тестирование на этом бенчмарке, показала точность 35,92%. В дальнейшем планируется сделать этнографический бенчмарк доступным научному сообществу. Это позволит использовать его в качестве инструмента для оценки других языковых моделей.
В рамках партнерства Международного общества «Қазақ тілі» и OpenAI продолжится работа по расширению баз текстовых и аудиоданных на казахском языке, повышению их качества, защите персональных данных и совершенствованию инструментов оценки моделей искусственного интеллекта.
Справка:
OpenAI, Inc. – американская компания, занимающаяся исследованиями и разработками в области технологий искусственного интеллекта. Ее миссия – сделать так, чтобы искусственный интеллект приносил пользу всему человечеству.